La vague actuelle d'attention autour de Claude est facile à décrire dans le langage du marché et beaucoup plus difficile à décrire dans un langage scientifique. Le marché demande : est-il en tête ? Gagne-t-il ? Est-ce le modèle de code que les gens veulent utiliser aujourd'hui ? Une perspective scientifique pose d'autres questions : utile pour quoi ? dans quelles conditions ? avec quels modes d'échec ? Et, peut-être surtout, quel type de confiance les preuves disponibles permettent-elles réellement de justifier ?
Au 6 avril 2026, la discussion autour de Claude ne se limite plus à la fluidité conversationnelle. Elle concerne de plus en plus l'édition de code, l'exécution agentique, le long contexte, les évaluations de sûreté et la discipline de déploiement. Ce déplacement est important, car il fait de la vague Claude un cas d'étude utile pour comprendre comment les IA de pointe devraient être évaluées : non comme une capacité unique résumée par un score, mais comme un système dont la performance dépend de la conception de la tâche, de l'interface, des outils, des conditions adversariales et de la gouvernance.
L'utilité n'est pas une propriété du modèle pris isolément
n travail scientifique, l'une des façons les plus rapides de mal comprendre un système consiste à traiter sa performance comme une propriété intrinsèque détachée du contexte. Les modèles de pointe sont particulièrement vulnérables à cette erreur. On dit qu'un modèle est « bon en code » ou « bon en raisonnement » comme s'il s'agissait de vérités stables et indépendantes du contexte. En pratique, le comportement utile dépend d'un système couplé :
où M désigne le modèle, T la tâche, C le contexte disponible, S le scaffolding ou l'environnement d'outils, et H la boucle de supervision humaine. Ce cadrage n'est pas un artifice rhétorique. C'est la manière la plus simple d'expliquer pourquoi un même modèle peut sembler brillant dans un workflow et fragile dans un autre.
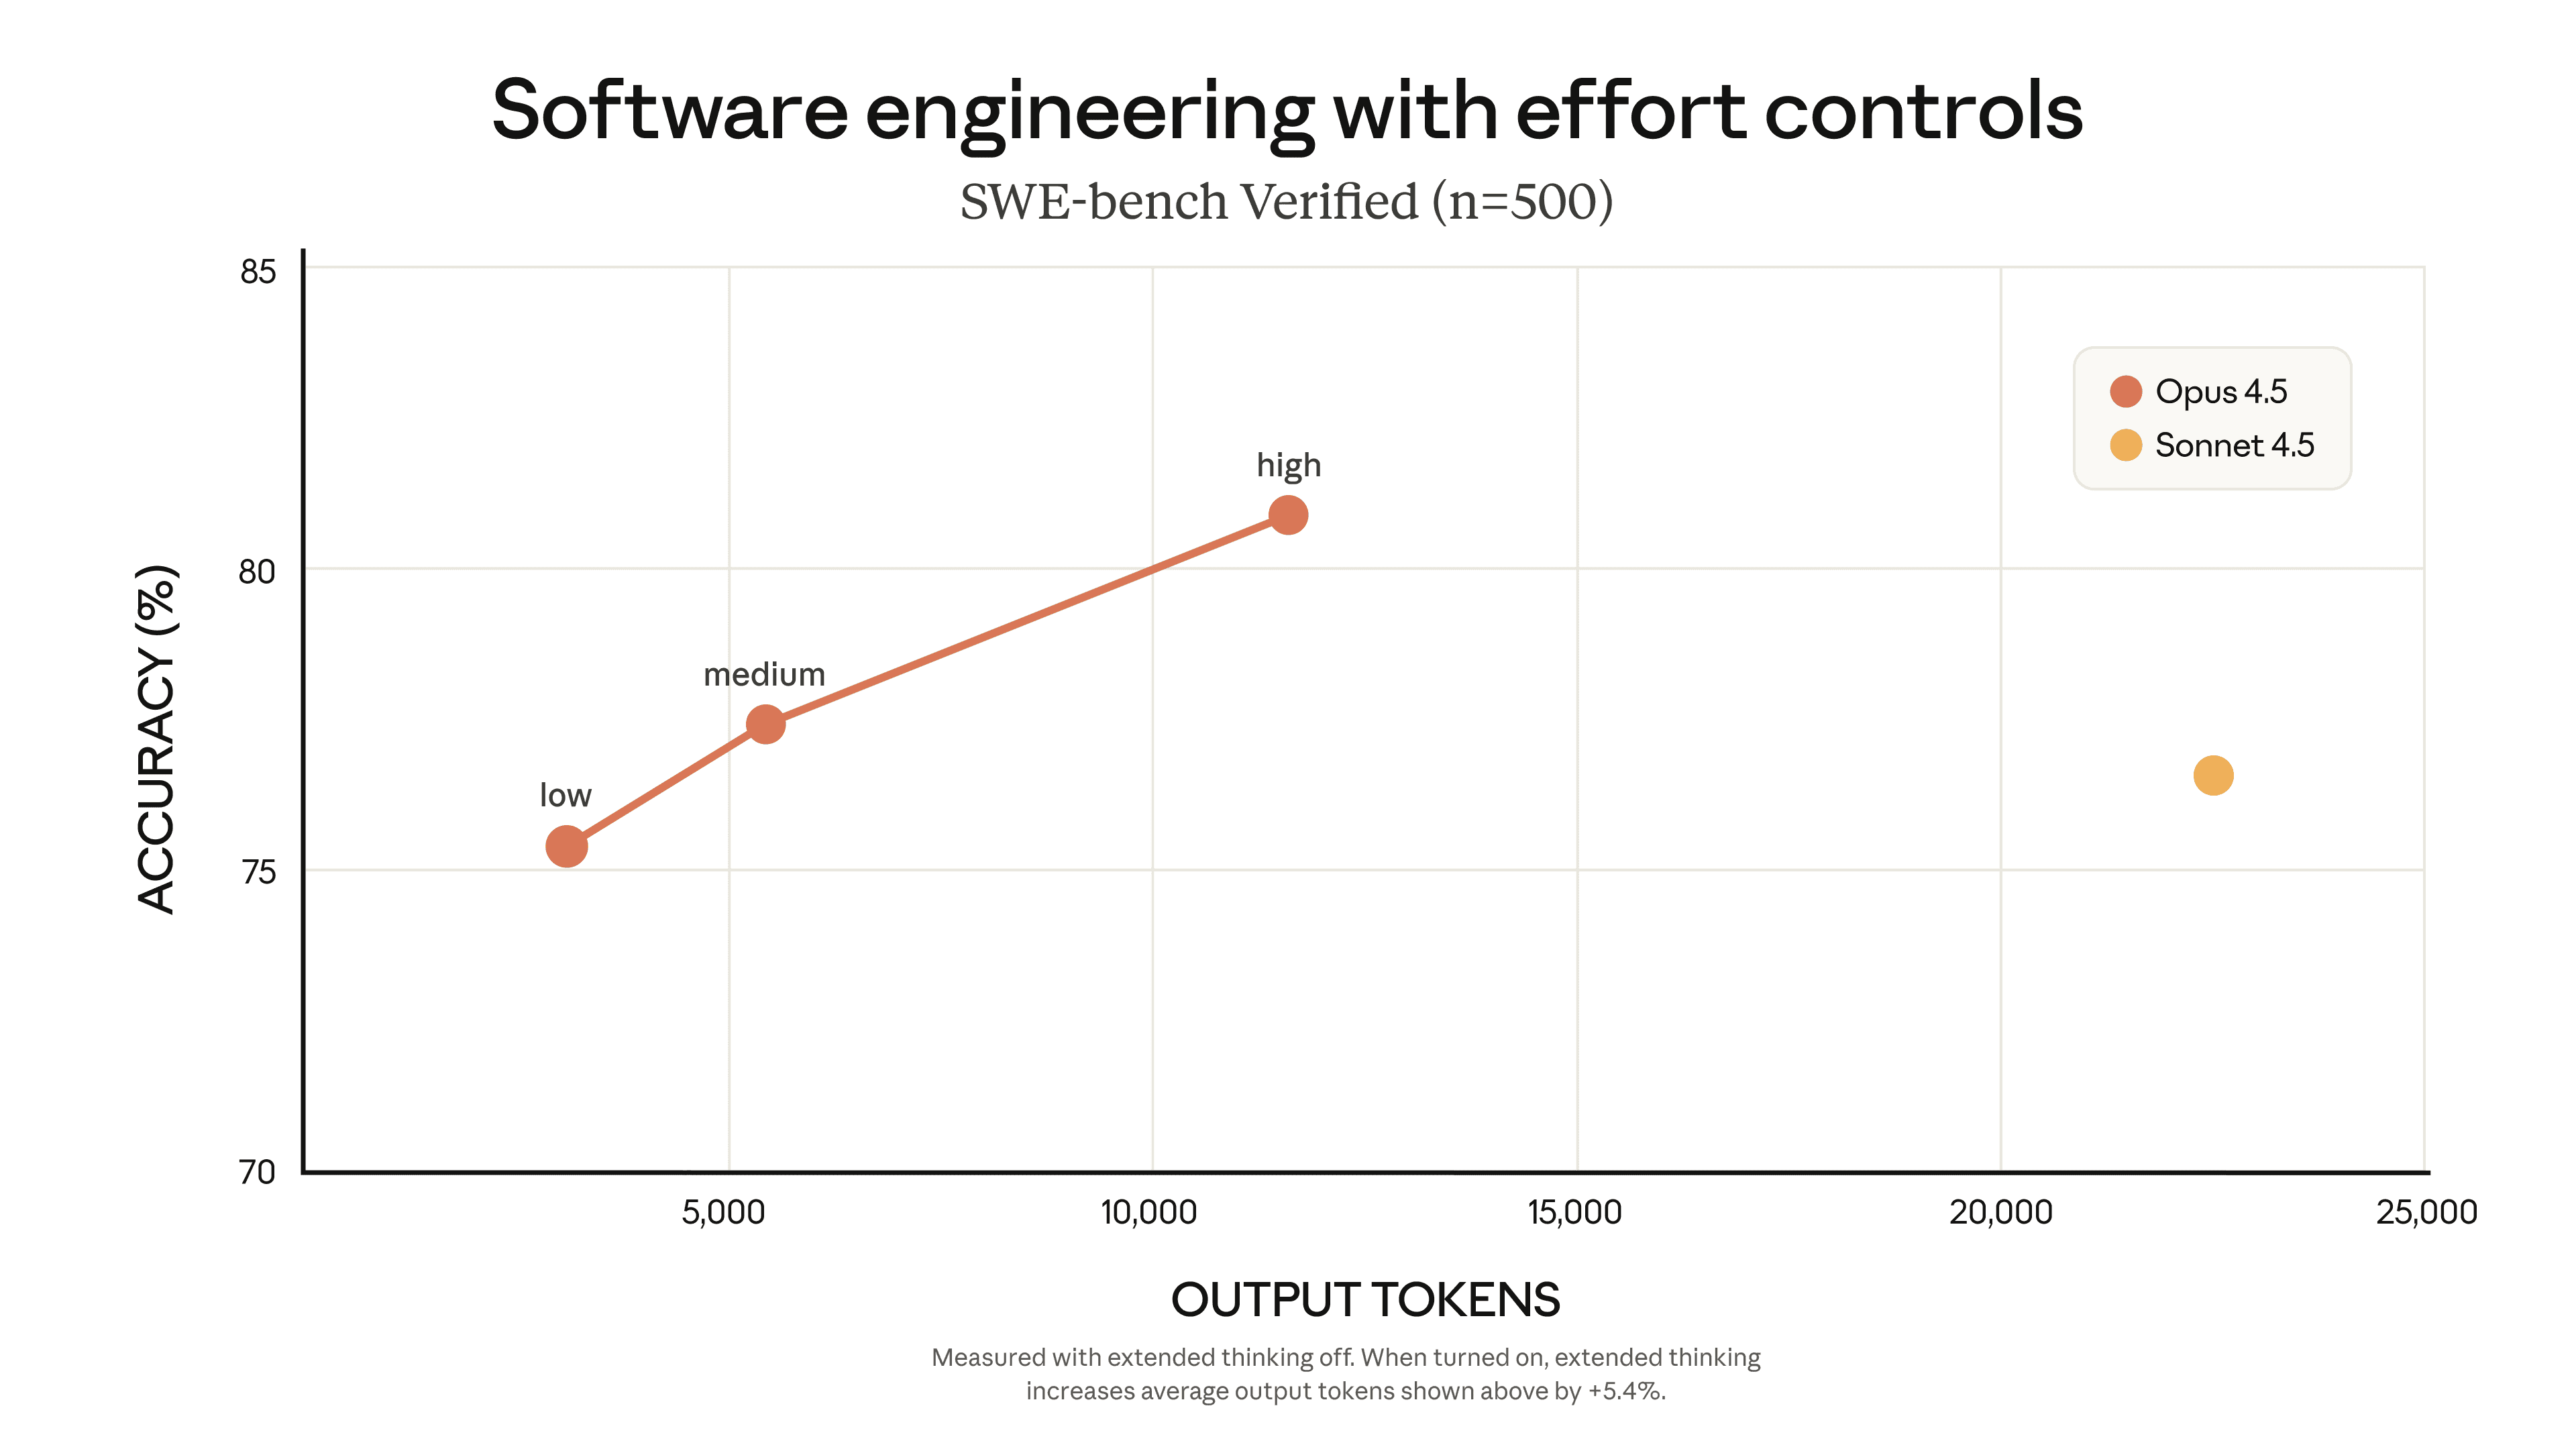
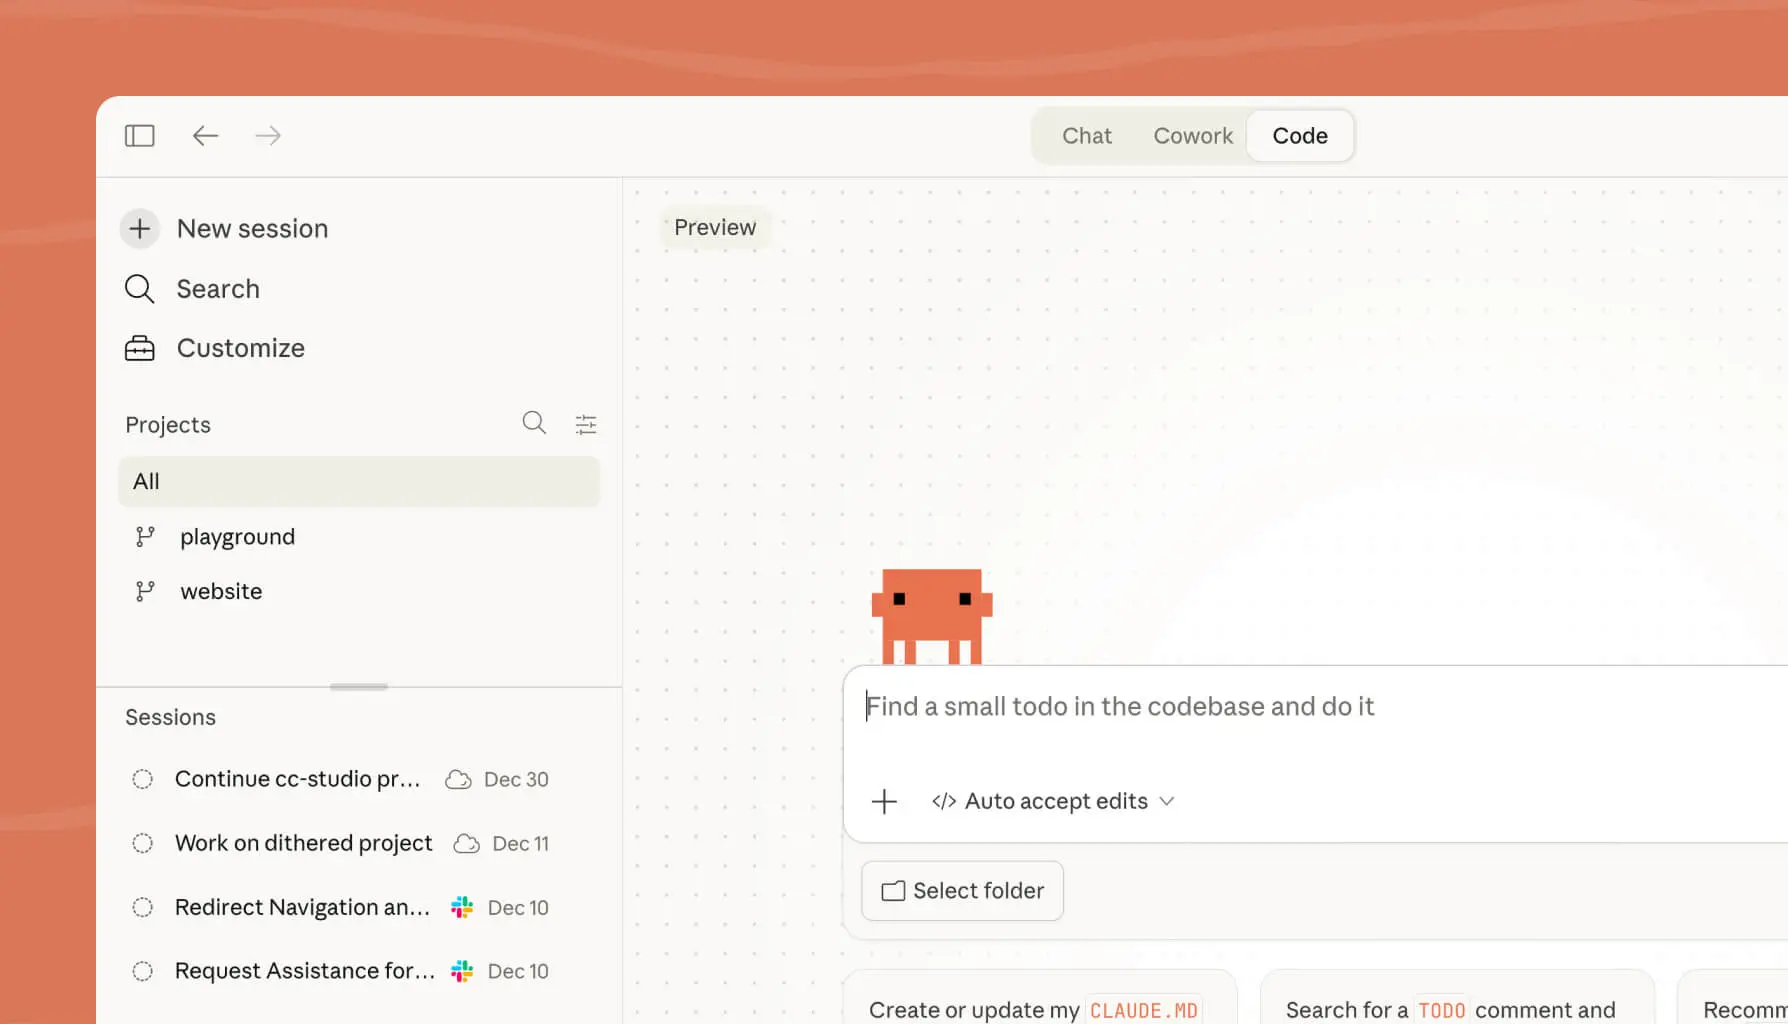
La réputation actuelle de Claude est fortement liée à des configurations où ce système complet joue en sa faveur : environnements de code, tâches plus longues, usage d'outils, prompts structurés, accès aux fichiers et interaction répétée plutôt que réponses one-shot. C'est précisément pour cela que des produits comme Claude Code sont importants scientifiquement. Ce ne sont pas de simples enveloppes UX autour d'un modèle ; ils font partie de la chaîne causale qui convertit la capacité brute en utilité observée.
Pourquoi Claude paraît particulièrement utile dans les workflows techniques
l existe plusieurs raisons pour lesquelles Claude fonctionne bien dans les contextes qui dominent aujourd'hui la discussion publique. D'abord, beaucoup de tâches très visibles mettent désormais l'accent sur le codage agentique multi-étapes : parcourir une base de code, localiser des contraintes, modifier plusieurs fichiers, interpréter des échecs de tests et recommencer. Dans ces environnements, le long contexte et le suivi stable de la tâche comptent davantage que l'éloquence.
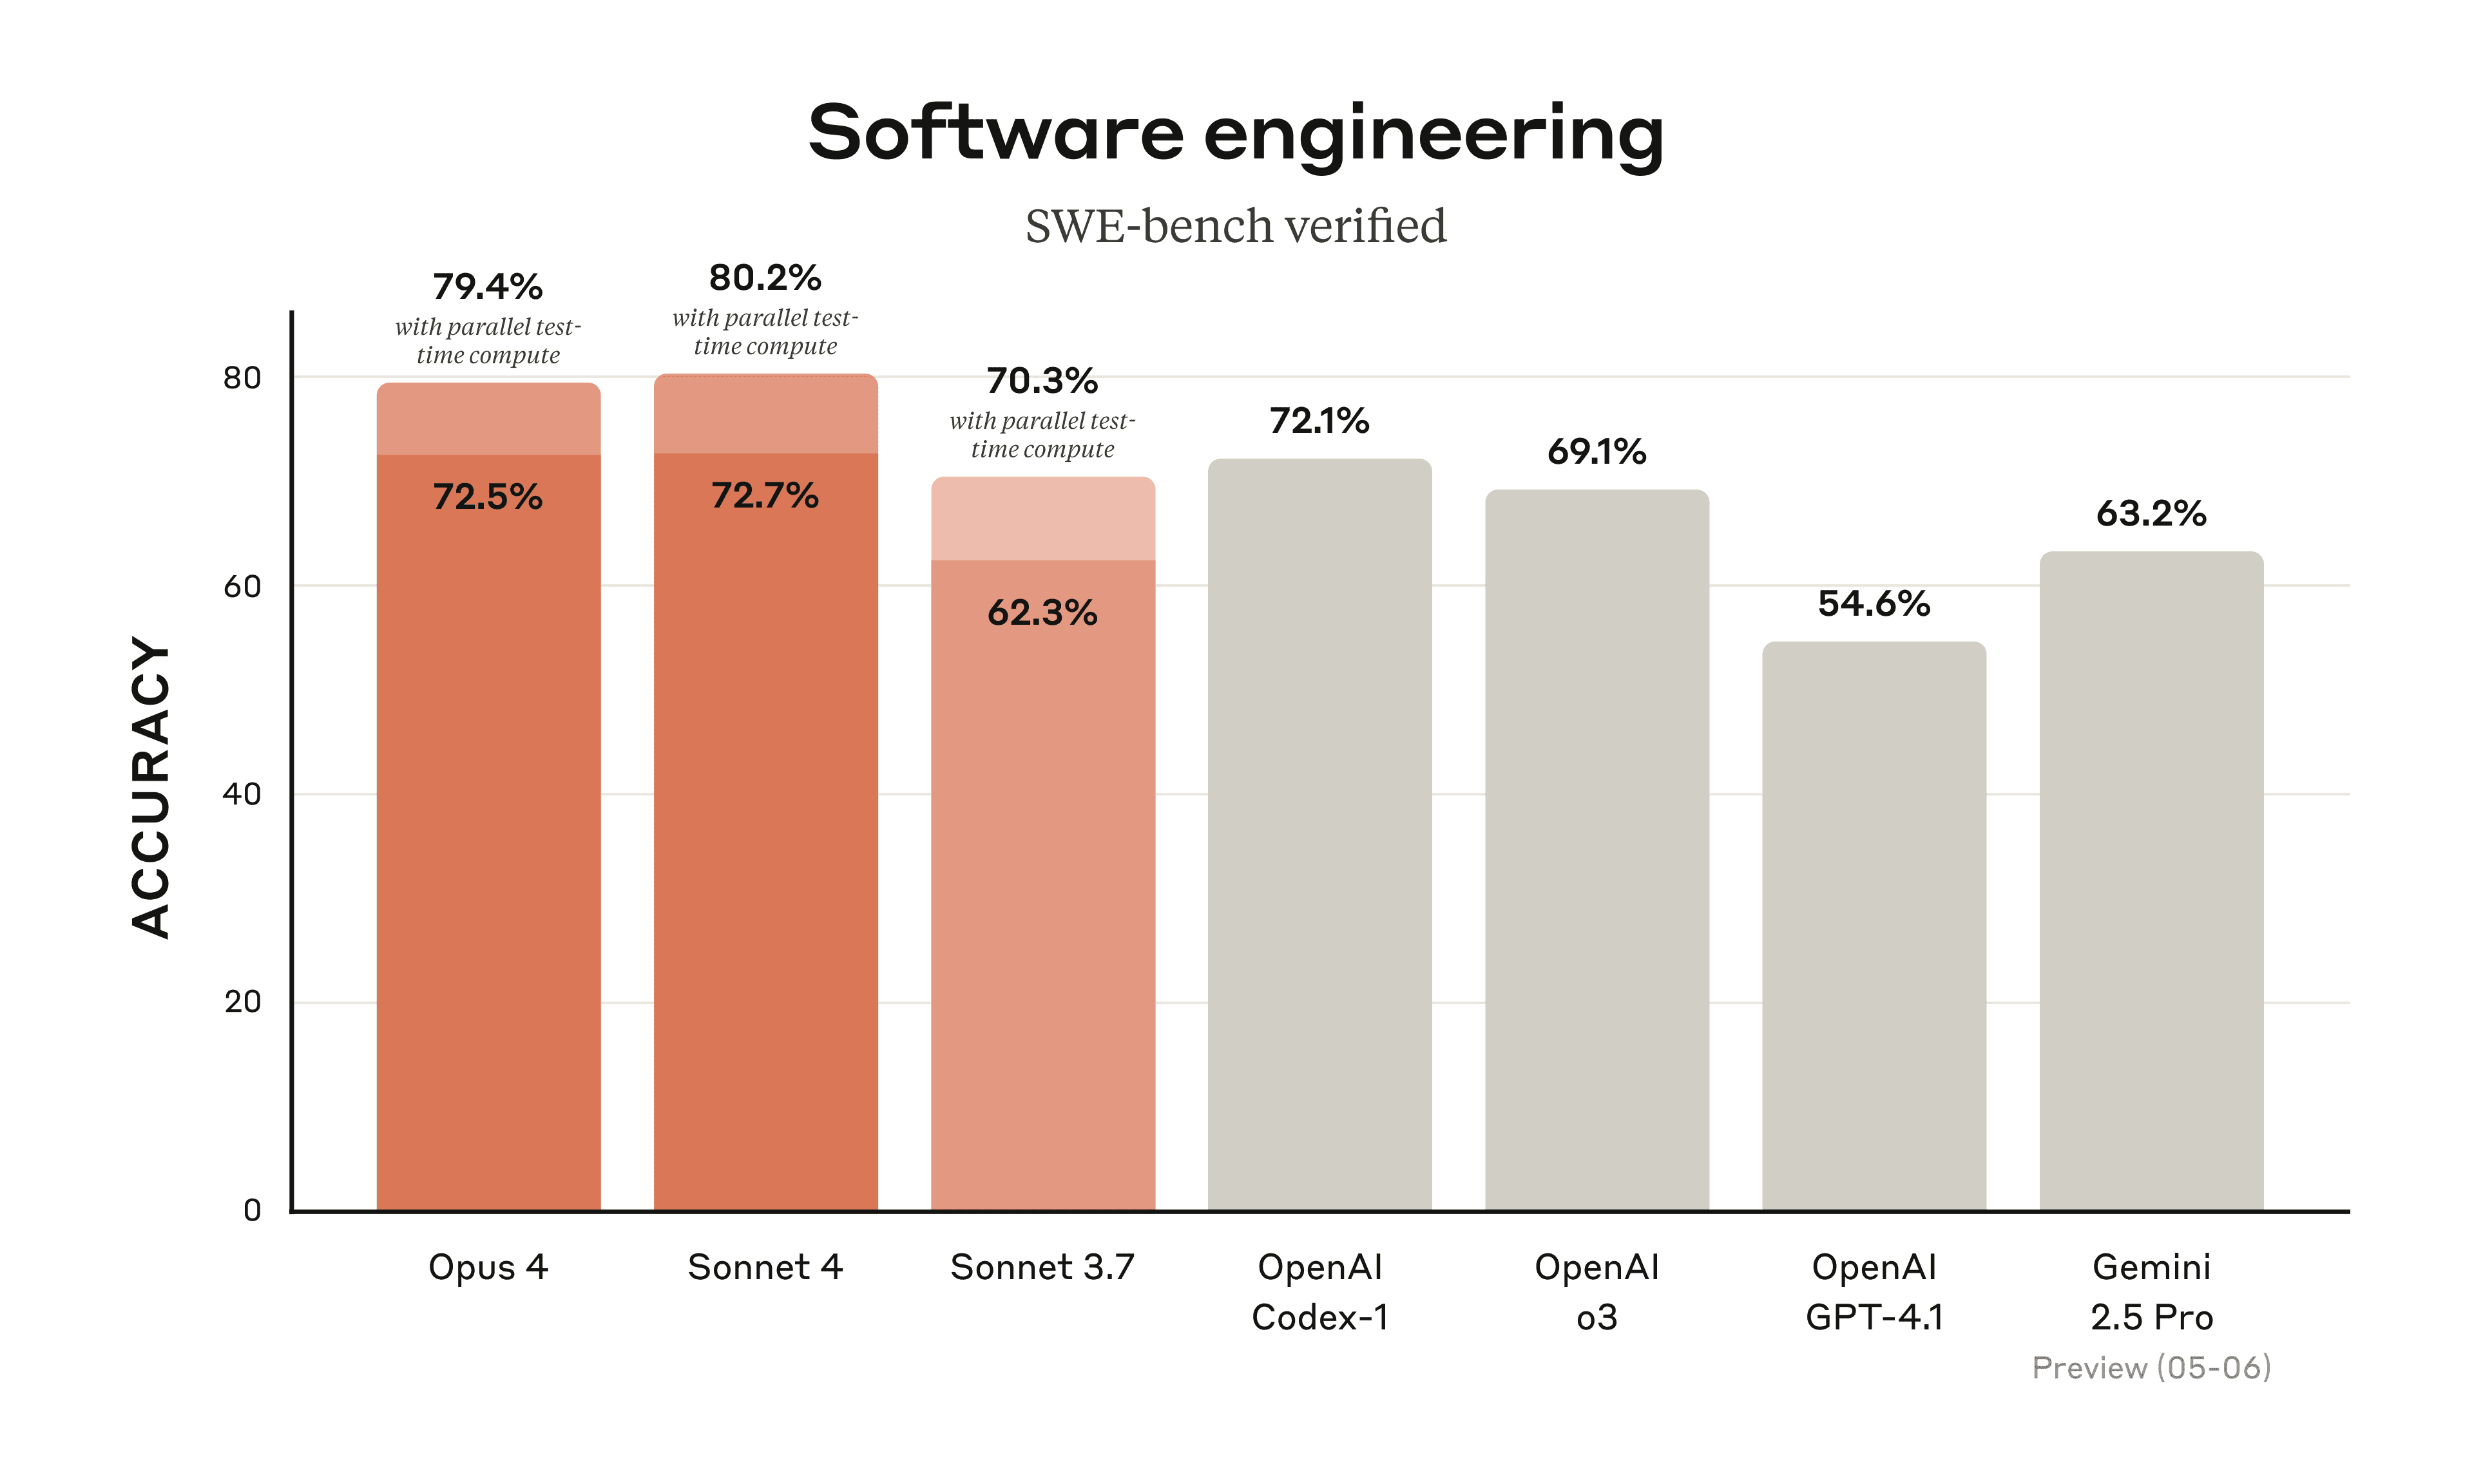
Ensuite, la culture actuelle de l'évaluation valorise de plus en plus les performances sur les tâches d'ingénierie logicielle, parce qu'elles sont économiquement lisibles. Cela change la signification publique de la qualité d'un modèle. Un résultat de benchmark sur le code n'équivaut pas automatiquement à une intelligence générale, mais il est plus facile pour les équipes de le relier à leur travail quotidien qu'un simple score de raisonnement abstrait. C'est une des raisons pour lesquelles la vague Claude paraît si concrète : ses affirmations les plus visibles sont proches de workflows que les développeurs reconnaissent immédiatement.
Enfin, Anthropic a accompagné ses revendications de capacité par une documentation publique plus solide que ce que beaucoup d'utilisateurs attendent. Les system cards, le langage de gouvernance, les références à la Constitution et les mises à jour de la Responsible Scaling Policy n'éliminent pas le risque. Mais ils rendent Claude plus facile à discuter en termes scientifiques et de déploiement que s'il n'était promu qu'à travers des démos et des slogans.
Les principales limites ne sont pas du bruit accidentel
ne perspective scientifique devient particulièrement précieuse lorsque l'enthousiasme monte, car c'est à ce moment-là que l'on est tenté de traiter les limites comme de petites exceptions. Ce n'est pas le cas. Pour des systèmes comme Claude, les limites sont structurées. Elles apparaissent en grappes reconnaissables.
Une première grappe concerne la dépendance à l'évaluation. La performance est très sensible au scaffolding des prompts, aux outils autorisés, à la manière d'emballer le contexte, aux réglages de calcul ou d'« effort », et à la façon dont le succès est mesuré. Un benchmark peut être significatif sans être universel. Cela ne rend pas les évaluations inutiles ; cela signifie que leur domaine de validité doit être respecté.
Une deuxième grappe concerne la fragilité du contexte et du contrôle. Les longues fenêtres de contexte sont utiles, mais une grande fenêtre n'est pas synonyme de raisonnement fiable sur un horizon long. La récupération, la priorisation, la cohérence locale et la capacité à se reprendre après un échec restent décisives. Les modèles peuvent tenir plus d'information qu'ils ne peuvent réellement organiser avec constance.
Une troisième grappe concerne les surfaces adversariales. Le prompt injection, l'usage abusif des outils, les instructions cachées, le contexte empoisonné et les attaques au niveau de l'environnement ne sont pas des cas limites marginaux pour des systèmes agentiques. Ce sont des problèmes techniques centraux.
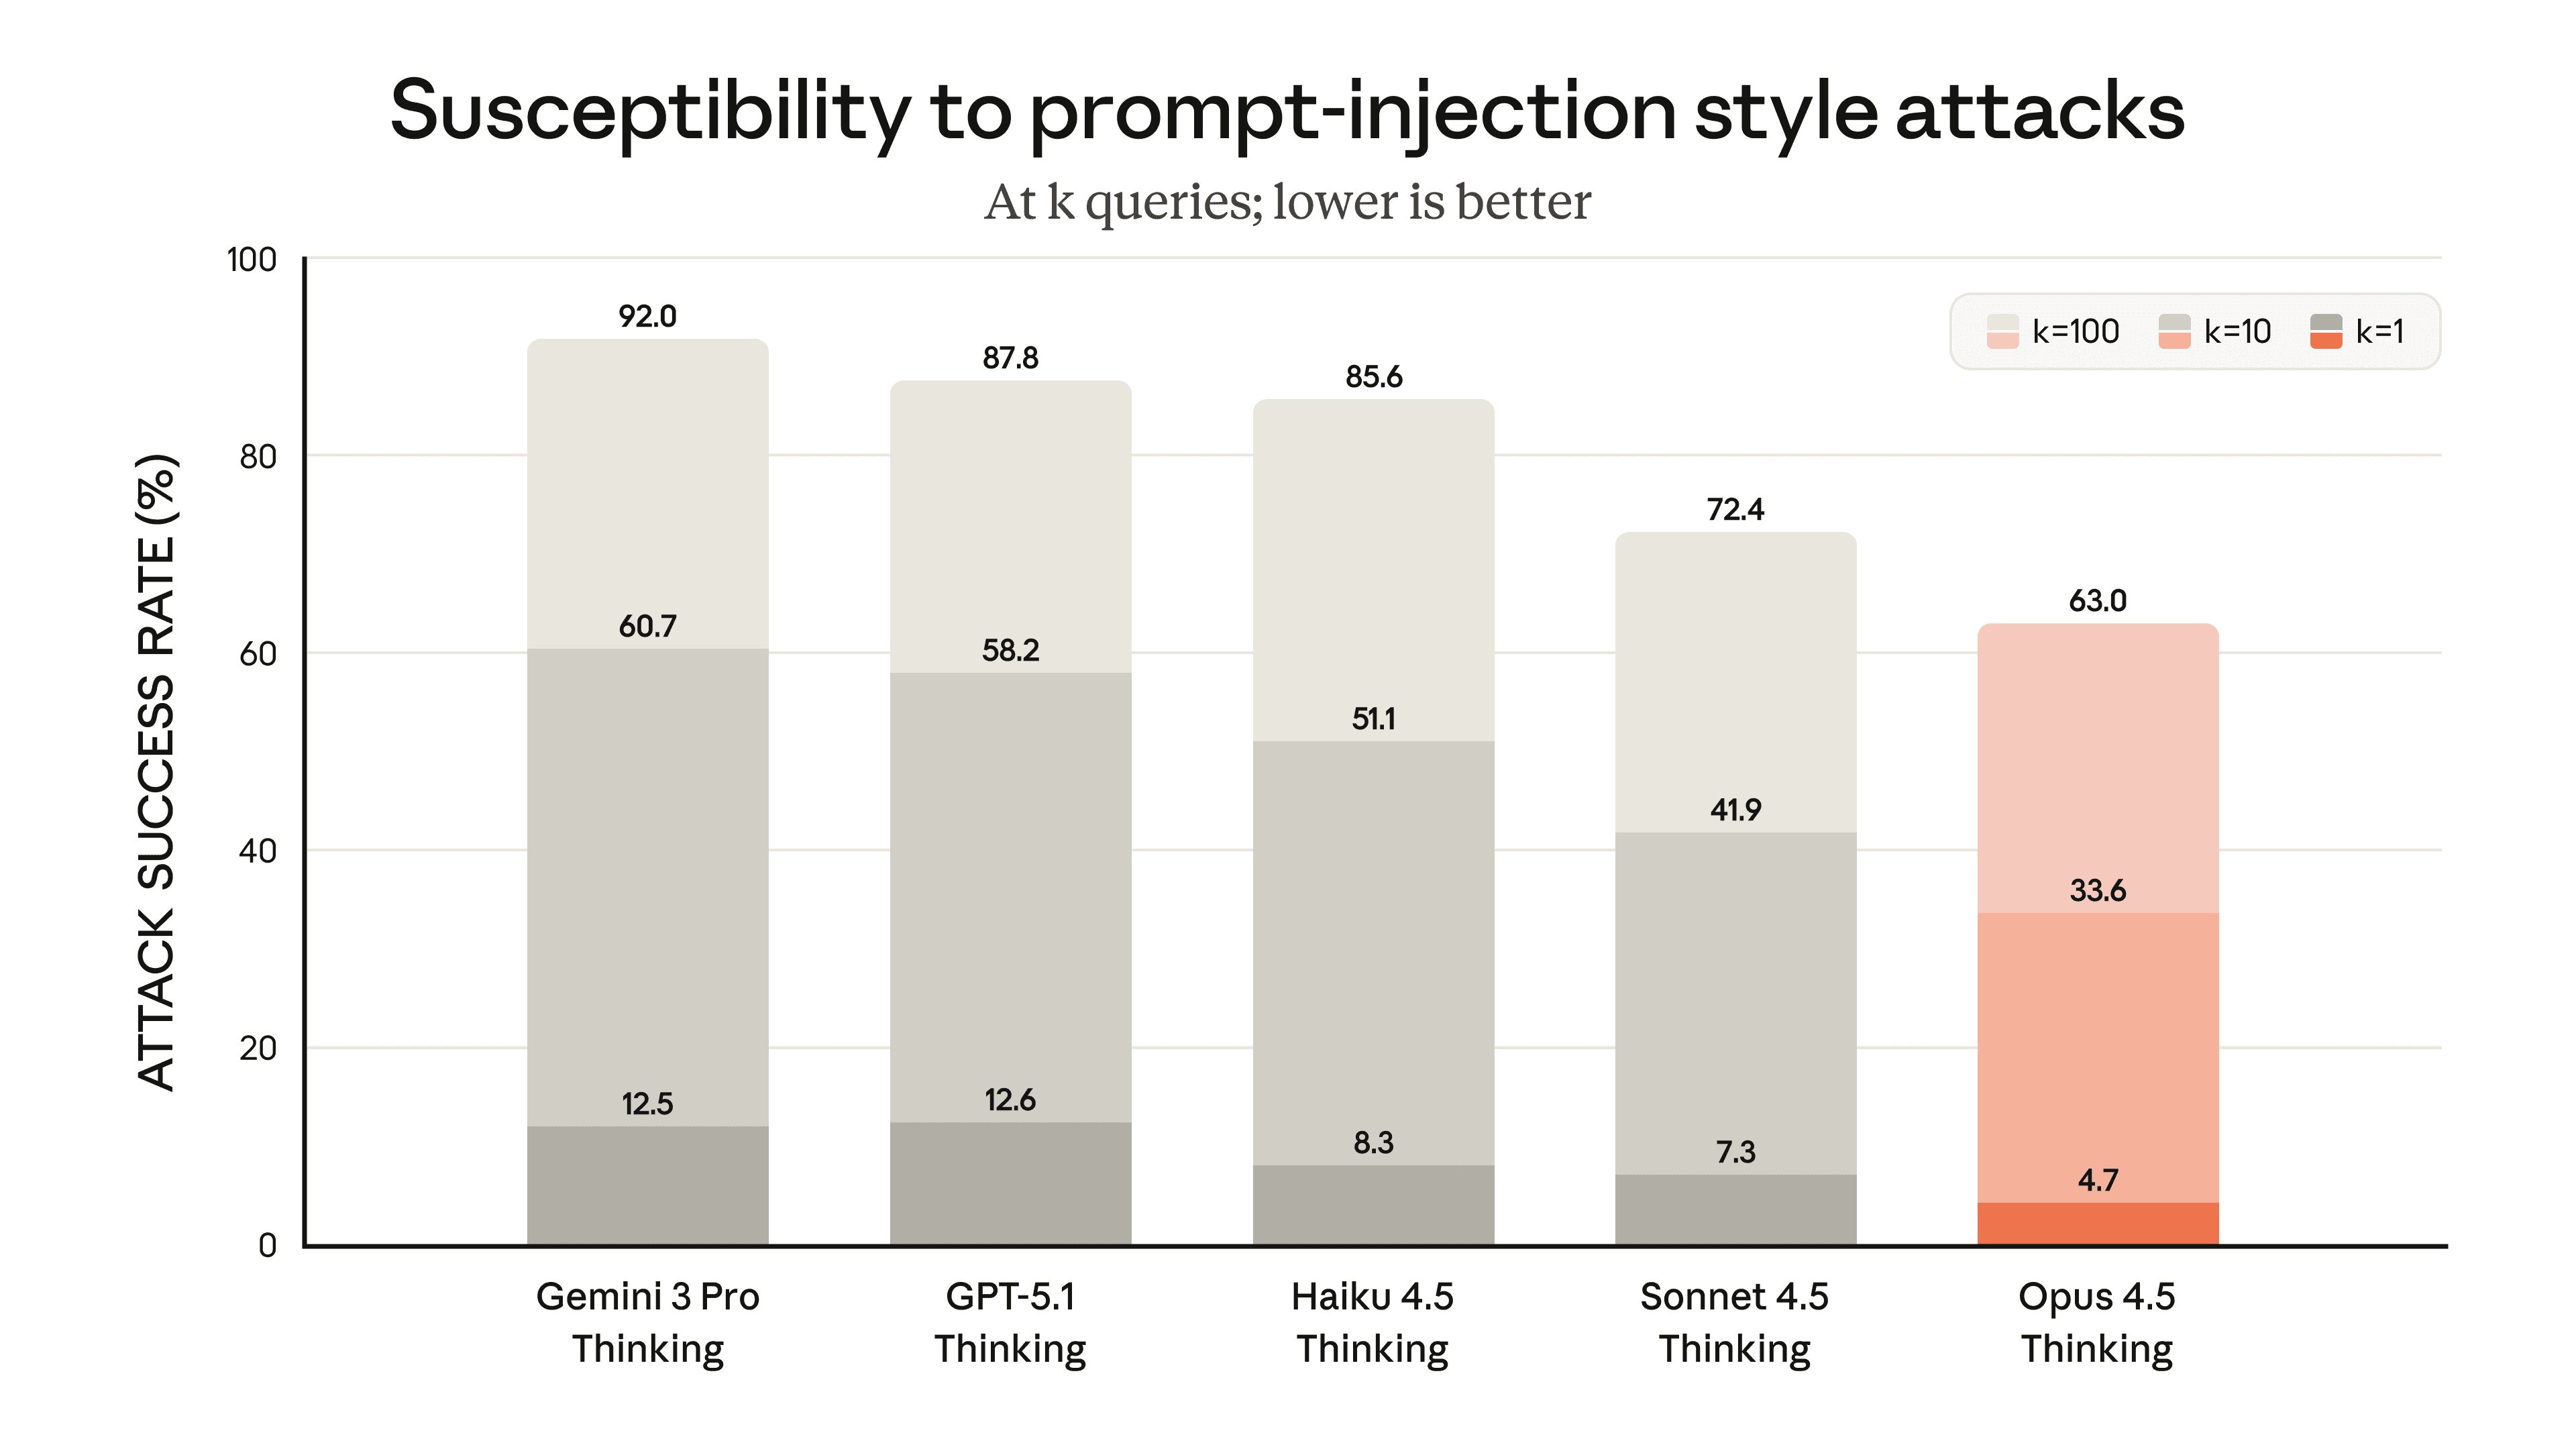
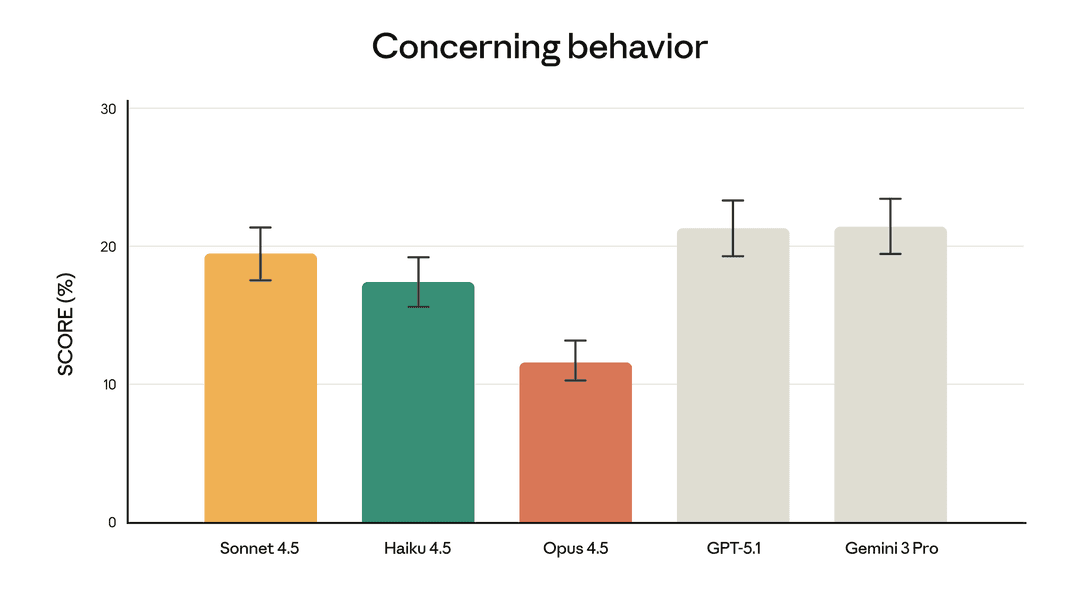
C'est là que la discussion scientifique devient plus sérieuse. Une fois qu'un modèle est utilisé comme agent plutôt que comme simple générateur de texte, la question n'est plus « sait-il bien répondre ? », mais « comment se comporte-t-il lorsque le contexte est manipulé, lorsque les instructions entrent en conflit, ou lorsque l'environnement lui-même devient une partie de la surface d'attaque ? » Les évaluations publiques d'Anthropic autour du prompt injection et des comportements préoccupants sont précieuses précisément parce qu'elles rendent ce problème explicite.
La confiance doit être traitée comme une calibration, pas comme une croyance
a confiance dans l'IA est souvent discutée de façon trop émotionnelle. Soit on fait confiance à un modèle parce qu'il paraît impressionnant, soit on s'en méfie parce qu'il échoue de manière visible. Une posture scientifique plus utile consiste à définir la confiance comme une attente calibrée sous incertitude. Cela revient à demander ce que les preuves permettent réellement d'affirmer, et ce qu'elles ne permettent pas.
Ici, C représente la capacité démontrée, R la robustesse sous stress et sous attaque, O l'observabilité de l'échec, et G la gouvernance ou la discipline de déploiement. Un système peut être impressionnant sur un terme et faible sur un autre. C'est exactement pour cette raison que la confiance ne peut pas être réduite à une position sur un leaderboard.
Dans le cas de Claude, il existe de vraies raisons de prendre la question de la confiance au sérieux plutôt que de la balayer comme du marketing. Anthropic publie des model system cards, parle ouvertement de sa Constitution et de sa Responsible Scaling Policy, et documente des évaluations sur les usages abusifs, les comportements préoccupants et la robustesse adversariale. Ce sont des signaux significatifs. Ils créent une trace inspectable de revendications, de méthodes et de jugement de déploiement.
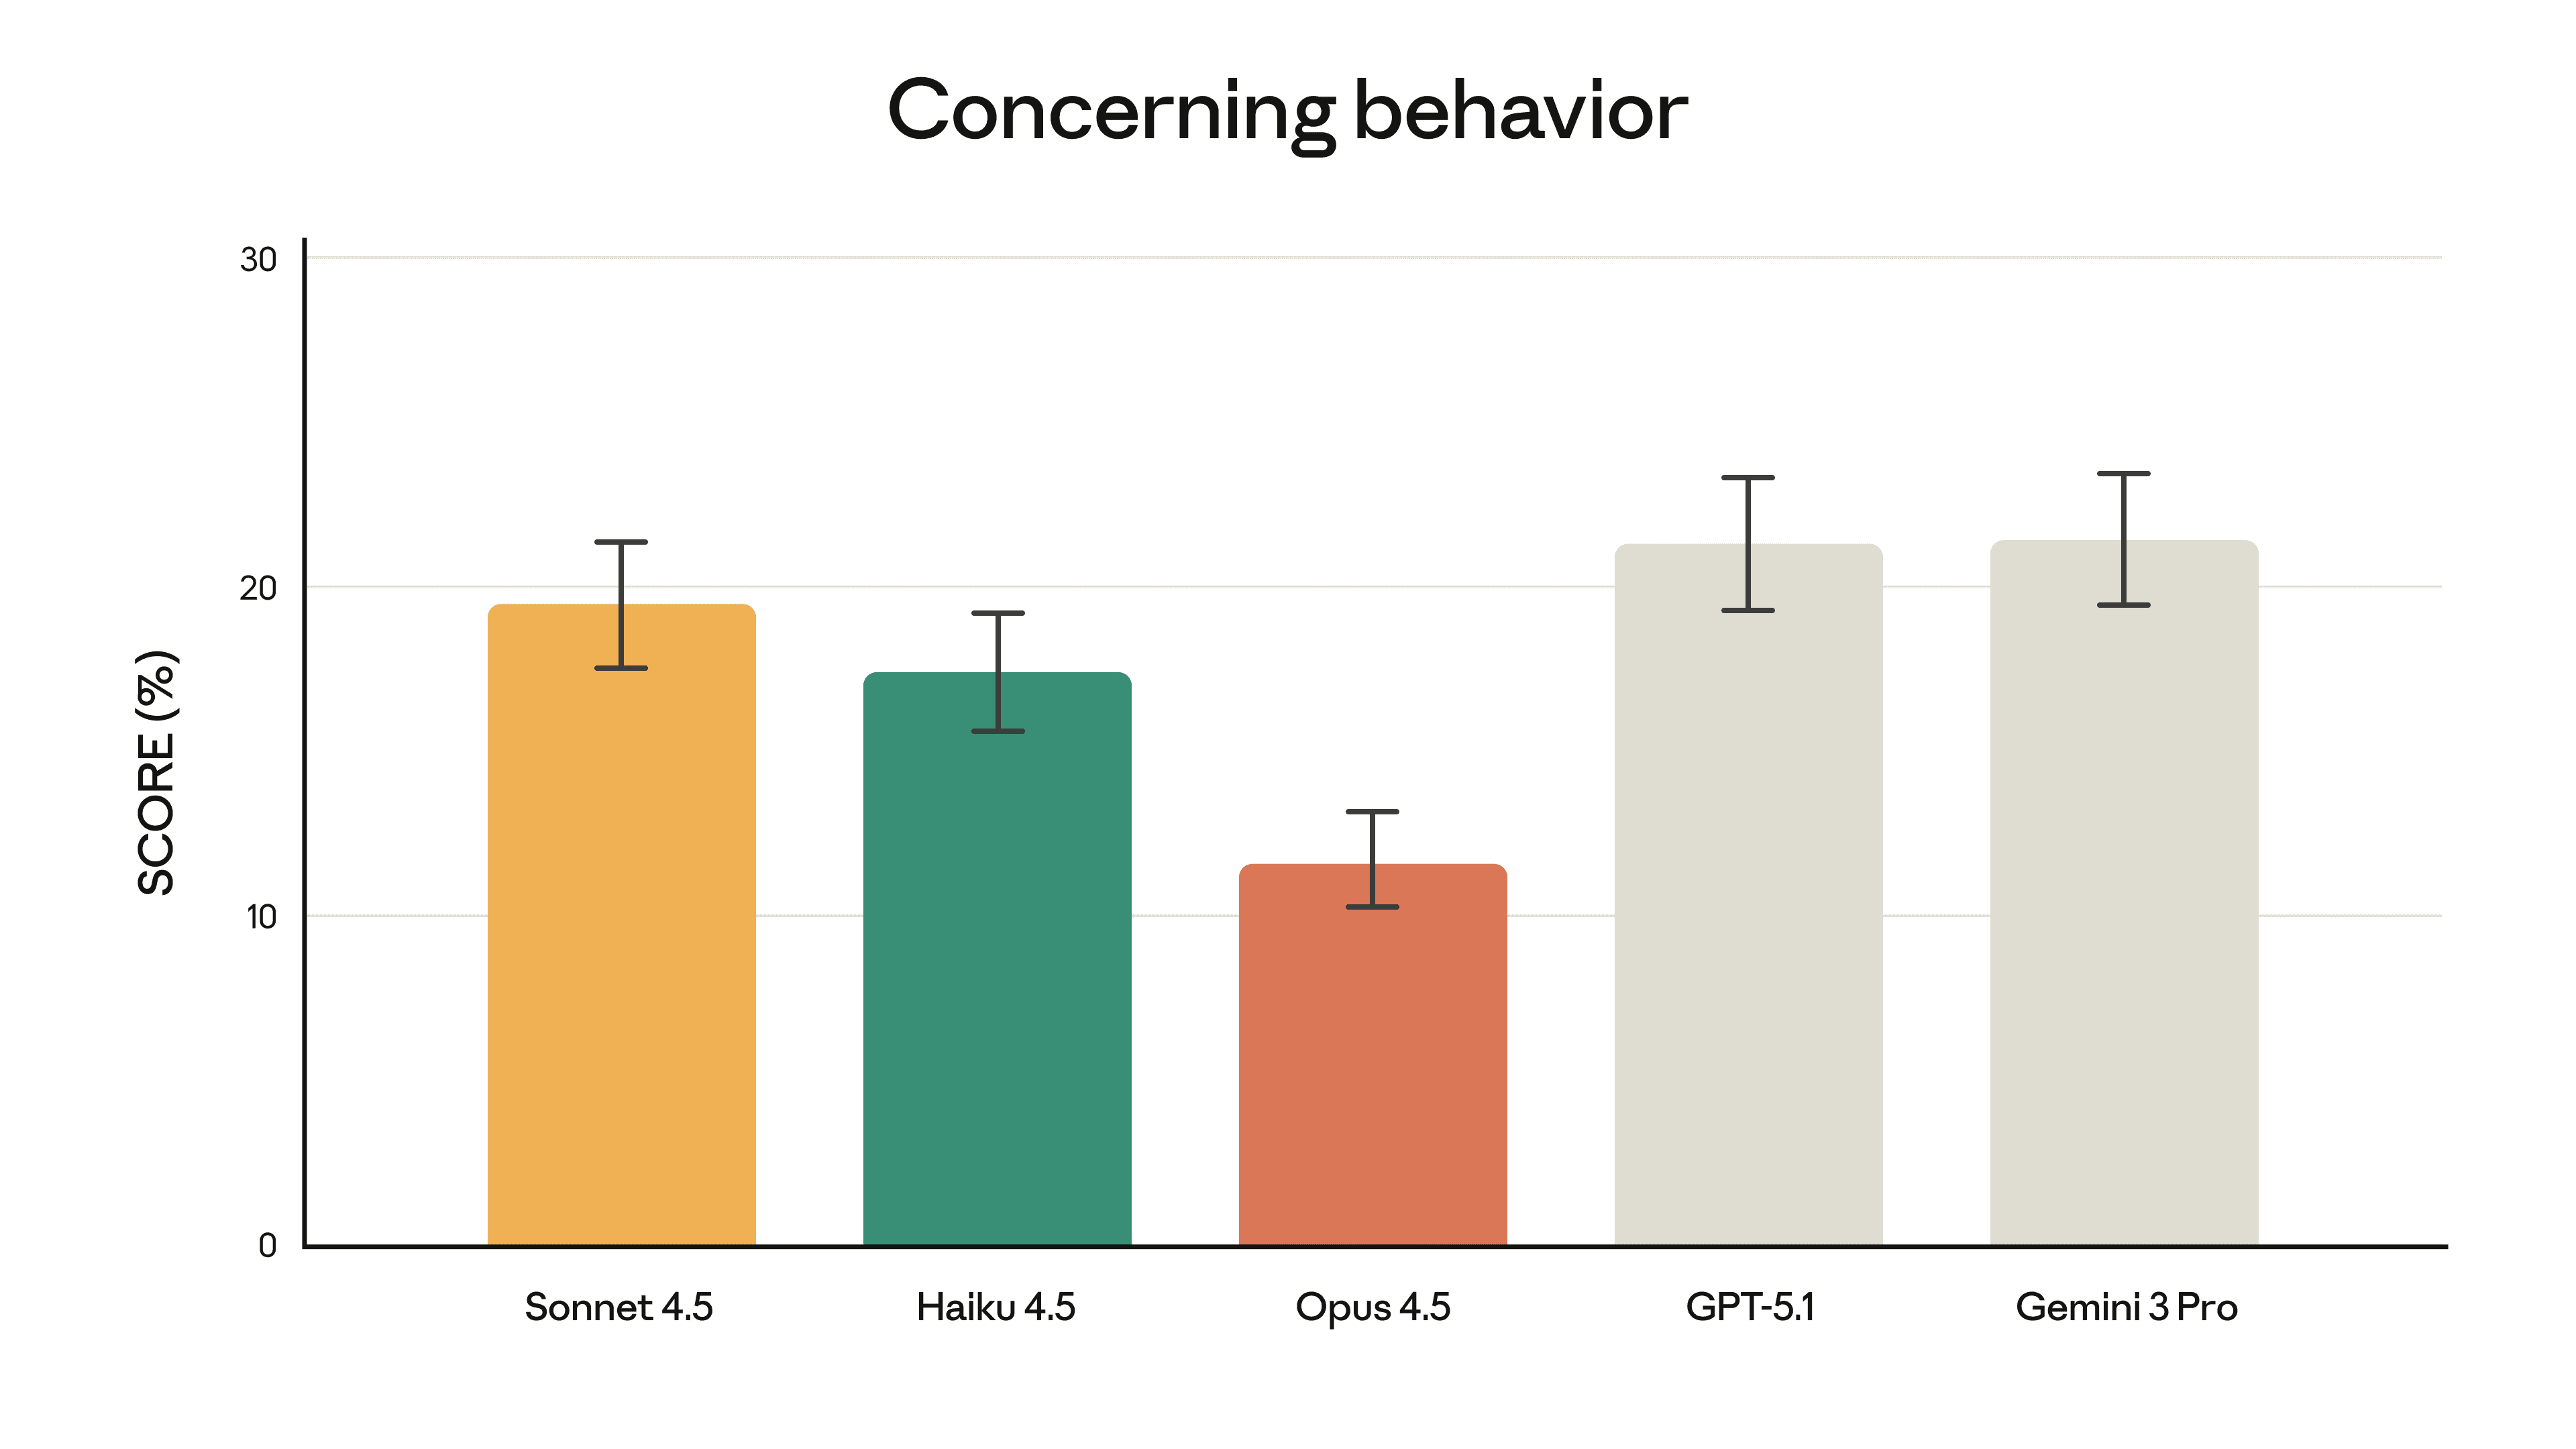
Mais la calibration exige de la symétrie. Les mêmes preuves qui soutiennent une confiance limitée soutiennent aussi une prudence limitée. Une documentation publique n'implique pas une transparence totale ; une première place sur benchmark n'implique pas une fiabilité universelle ; de meilleurs scores de sûreté n'impliquent pas une immunité à l'usage abusif ou à la mauvaise généralisation. La confiance n'est justifiée que lorsqu'elle est accompagnée de frontières claires : quelles tâches sont dans le périmètre, quels mécanismes de suivi existent, quelles formes de revue humaine restent nécessaires, et quelles classes d'échec restent non résolues.
La spéculation fait partie de la vague Claude, mais la spéculation n'est pas une preuve
n autre aspect scientifiquement intéressant de la vague Claude est qu'elle a déjà généré une couche secondaire de commentaires prospectifs sur des futurs non encore publiés ou seulement supposés. Un bon exemple est l'article de Dr Dipen publié sur Newline le 30 mars 2026 et intitulé Meet Claude Mythos: An Advance AI Model that is yet to be released in future from Anthropic. Même sans traiter ce type de texte comme une confirmation technique, son existence est révélatrice.
Pourquoi ? Parce que la spéculation modifie les attentes. Dès que la conversation publique commence à projeter de futures variantes de Claude, des capacités attendues, des performances supposées, ou des applications futures avant toute sortie officielle, l'écosystème n'est plus évalué uniquement sur les preuves présentes. Il est évalué sur un mélange de résultats mesurés et de trajectoires anticipées.
Ce mélange compte opérationnellement. Les équipes peuvent sur-attribuer des capacités, les chercheurs peuvent déplacer inconsciemment leurs lignes de base, et les décisions produit peuvent être influencées par l'élan narratif plutôt que par des données de déploiement validées. D'un point de vue scientifique, le discours spéculatif n'est donc pas sans importance, mais il appartient à une catégorie nettement différente de celle des system cards, des méthodologies d'évaluation publiques ou des politiques de déploiement documentées.
La vague Claude devient bien plus facile à raisonner une fois ces catégories séparées. L'enthousiasme peut être informatif. La spéculation peut être intéressante. Mais la confiance devrait rester ancrée dans la première catégorie.
Une grille scientifique pratique pour juger la vague Claude
our les chercheurs, les ingénieurs et les équipes techniques, la bonne réponse à la vague Claude n'est ni le rejet, ni l'abandon à la hype. C'est une inspection disciplinée. Je pense que cinq questions comptent particulièrement :
Ces questions déplacent la discussion du fandom vers l'ingénierie. Elles aident aussi à comprendre pourquoi la vague Claude importe au-delà d'Anthropic lui-même. C'est un cas test pour la manière dont la frontière est désormais jugée : non sur le seul spectacle du modèle, mais sur la capacité à intégrer, mesurer, borner et gouverner les performances.
Conclusion : l'utilité mérite l'enthousiasme, la confiance mérite une méthode
laude mérite l'attention parce qu'il se situe près du front d'une transition technique réelle : les modèles de pointe sont de plus en plus évalués comme des systèmes de travail plutôt que comme de simples moteurs de chat. En ce sens, l'enthousiasme n'est pas irrationnel. Il existe ici une utilité réelle, notamment dans le code, l'usage d'outils et le travail de connaissance structuré.
Mais une perspective scientifique impose une deuxième phrase. L'utilité n'annule pas les limites, et la confiance ne s'obtient pas par l'excitation seule. La lecture la plus mature de la vague Claude n'est donc pas triomphaliste. Elle est méthodologique. Claude est utile, parfois très utile. Claude possède aussi des limites qui comptent techniquement et opérationnellement. Et la confiance en Claude, comme pour tout modèle de pointe, devrait rester fondée sur les preuves, cadrée, et recalibrée en continu.
Ma propre conclusion est simple : la vague Claude mérite d'être prise au sérieux, mais seulement si nous la discutons avec le langage de la science plutôt qu'avec celui de l'inévitabilité. La vraie question utile n'est pas de savoir si Claude est « le gagnant ». C'est de savoir si nous pouvons mesurer, contraindre et faire confiance à ses forces avec assez de rigueur pour bien les utiliser.