maginez-vous dans une zone aride et isolée. Une communauté a besoin d’un nouveau puits, mais son budget ne permet de forer qu’une seule fois. Au mauvais endroit, la foreuse rencontre un rocher sec — tout le budget est perdu et l’eau n’arrive pas. Comment « voir » à des centaines de mètres de profondeur pour repérer la fine zone fracturée qui contient de l’eau ? On ne le peut pas… mais on peut utiliser la physique. On déploie un émetteur et une boucle de fil (un système EM) pour « exciter » le sous-sol avec un champ magnétique. Des récepteurs en surface enregistrent l’« écho » — un ensemble de nombres complexes et bruités.
Et ensuite ? Vous avez les données, mais pas la carte. L’étape clé manquante est l’inversion : un algorithme puissant qui remonte de ces nombres bruts vers le modèle 3D du sous-sol qui a dû les produire. Cet algorithme est le moteur qui transforme des données obscures en découverte exploitable. Ce blog est un guide pas à pas pour construire ce moteur à partir des premiers principes.
Nous y élaborons une inversion EM moderne depuis la base. Nous partons de la physique du problème et construisons son cœur : une fonction objectif stable qui équilibre l’ajustement aux données et les contraintes géologiques connues.
À partir de là, nous déduisons le « moteur » de l’inversion — l’algorithme de Gauss–Newton / Levenberg–Marquardt (LM). Nous montrons ensuite l’idée centrale : cette même logique se généralise d’un solveur 1D simple à un modèle 3D complet, sans stocker explicitement de grandes matrices (matrix-free). En chemin, nous détaillons la pondération des données, la régularisation et les diagnostics indispensables pour obtenir un résultat fiable.
Qu’est-ce que l’inversion, et pourquoi en avons-nous besoin ?
ien avant d’écrire la moindre ligne de code, posons une question simple : comment « voir » ce que l’on ne peut pas toucher ?
Imaginez que vous êtes sur un bateau dans un épais brouillard. Vous ne voyez pas le fond marin, mais vous avez un sonar. Vous envoyez un « ping » (une onde sonore) dans l’eau. C’est le problème direct : utiliser une physique connue pour prédire ce qui va se passer. Quelques secondes plus tard, un écho revient : c’est votre donnée. Votre cerveau fait immédiatement le calcul : « D’après le temps d’aller-retour et l’intensité, le fond est à 100 m et plutôt rocheux. » Cette opération mentale — convertir des données observées en un modèle invisible du monde — c’est l’essence de l’inversion : retrouver la cause (le modèle) à partir de l’effet (les mesures).
“L’inversion n’est pas magique — c’est de la physique, de l’optimisation et une incertitude vérifiée.
”
En effet, un médecin utilise un scanner (CT) pour la même raison : on ne peut pas voir l’intérieur du corps à l’œil nu, alors on fait passer des rayons X (physique), on mesure ce qui ressort (données), puis un ordinateur inverse ces mesures pour reconstruire un volume 3D de vos organes. L’inversion numérique est notre « scanner » pour la Terre : un processus mathématique et computationnel qui transforme des observations limitées et bruitées de surface en une image fiable — un modèle — du sous-sol invisible.
D’accord, alors qu’est-ce que l’inversion EM ?
Plutôt que d’envoyer un « ping » sonar ou des rayons X, nous utilisons l’électromagnétisme (EM). Une inversion EM procède ainsi :
- Transmettre (physique directe) : on génère un champ électrique et magnétique contrôlé qui pénètre dans le sol. C’est notre « ping ».
- Mesurer (données) : des récepteurs sensibles enregistrent les faibles champs secondaires renvoyés par la Terre. Différents milieux (eau douce, eau salée, corps minéralisés, hydrocarbures, etc.) ne réagissent pas de la même façon.
- Inverser (le modèle) : l’algorithme — celui que nous allons construire — prend ces mesures et résout l’énigme : « Quel modèle 3D de conductivité électrique en profondeur est le seul à pouvoir produire exactement les données que nous venons de mesurer ? »
Pourquoi c’est important : de l’eau aux minerais
Ce n’est pas qu’un exercice académique. L’inversion EM est le moteur qui permet de trouver :
- Eau souterraine : localiser des aquifères d’eau douce pour forer des puits au service des communautés.
- Minéraux critiques : identifier des gisements de cuivre, lithium ou nickel indispensables aux batteries et aux technologies vertes.
- Géothermie : cartographier les roches chaudes et réservoirs fluides pour produire une énergie propre.
- Sécurité environnementale : surveiller la diffusion de contaminants après un déversement.
- etc
Dans tous ces cas, le forage est coûteux et risqué. L’inversion nous permet de « forer » des milliers de fois à l’ordinateur d’abord, afin de ne forer qu’une seule fois sur le terrain. Maintenant, construisons le moteur.
Étape 1 : le modèle direct & la fonction objectif
eci correspond au « ping sonar » de notre problème. En inversion géophysique, il nous faut d’abord un modèle direct — la physique qui prédit ce que nous devrions mesurer. En EM harmonique (domaine fréquentiel), cette physique est régie par l’équation d’onde vectorielle.
Cette équation est notre bête de somme : elle décrit comment le champ électrique (notre « ping ») interagit avec le sous-sol. L’élément clé est le terme , qui encapsule les propriétés du milieu : . Cela signifie que si l’on modifie la conductivité (notre modèle), l’équation produira une réponse prédite différente (nos données).
Toute cette simulation physique se résume par une fonction : vous lui fournissez un modèle (la carte de conductivité) et elle renvoie les données simulées . Voilà pour le problème direct. Pour le problème inverse, nous disposons déjà des mesures réelles . Notre objectif est de trouver le modèle qui soit :
- Exact : il doit prédire nos données réelles ().
- Plausible : il doit être géologiquement raisonnable (p. ex. suffisamment lisse, sans artefacts chaotiques).
On impose cet équilibre en définissant un « score » — la fonction objectif — que l’on cherche à rendre aussi faible que possible. Elle comporte deux termes :
Ici, est l’écart aux données (data misfit), qui mesure l’erreur entre prédiction et observation. est la régularisation (ou « coût du modèle »), qui pénalise les modèles trop rugueux ou trop complexes. La valeur joue le rôle d’un curseur qui équilibre les deux : privilégie-t-on un ajustement parfait aux données, ou un modèle plus lisse ?
Le but de l’inversion devient alors simple : trouver le modèle qui minimise . Les prochaines étapes présenteront les algorithmes précis (Gauss–Newton et Levenberg–Marquardt) utilisés pour atteindre ce minimum.
Définir la « physique » de notre modèle direct
Soyons concrets. Notre n’est pas une idée en l’air : c’est une physique précise. Pour la plupart des levés EM, le cheval de bataille est la forme diffusive des équations de Maxwell — une simplification courante de l’équation d’onde complète de l’Éq. (1). Aux basses fréquences usuelles en géophysique, le courant de conduction () domine, tandis que le courant de déplacement () est si faible qu’on peut l’ignorer. On obtient alors l’EDP pratique suivante :
Cette équation est le cœur de : elle relie directement la propriété que l’on cherche — la conductivité (notre modèle ) — au champ électrique que l’on peut mesurer. Cette physique « diffusive » fournit aussi une règle d’or essentielle : la profondeur de peau, .
La profondeur de peau indique jusqu’où notre « ping » EM peut pénétrer. Les structures bien plus petites que seront mal résolues (floutées), et celles bien plus profondes que ne renverront pratiquement aucun écho. Cette formule simple sert de premier reality check pour concevoir un levé et choisir si un modèle 1D ou 2D suffit, ou s’il faut passer à une simulation 3D complète. (Astuce débutant : plus la conductivité ou la fréquence est grande, plus est petite ; on « voit » moins profond.)
De la physique aux données : ce que mesurent les instruments
n dispose d’un modèle direct (Éq. 3) qui prédit les champs électrique et magnétique partout dans le sous-sol. Mais nous ne pouvons pas tout mesurer : seulement quelques composantes en des points récepteurs à la surface. Les instruments enregistrent ces champs de surface et les convertissent en rapports robustes et interprétables. En MT/AMT/CSAMT, cela nous fournit deux observables clés :
- Tenseur d’impédance () : donnée principale. Il mesure le rapport entre les champs électriques horizontaux et les champs magnétiques horizontaux qui les induisent : .
- Tipper () : il quantifie le « basculement » du champ magnétique, reliant la composante verticale aux composantes horizontales : .
D’autres méthodes (FDEM, TDEM) peuvent enregistrer des composantes de champ directement. Mais dans tous les cas, qu’il s’agisse de , de ou de champs bruts, ce sont simplement des « vues » différentes d’une même physique sous-jacente. Ce sont les données observées que l’inversion cherchera à reproduire.
Choisir votre « modèle physique » : 1D, 2D ou 3D
Notre modèle direct résout l’EDP (Éq. 3). Son coût et sa complexité dépendent entièrement de la dimensionnalité — c’est-à-dire des hypothèses géométriques que l’on fait sur la Terre.
- 1D (Terre en couches) 🥞 : on suppose que les propriétés ne varient qu’avec la profondeur (). Énorme simplification ! L’EDP se réduit à un calcul ultra-rapide (transformée de Hankel). Idéal pour des contrôles rapides, des contextes simples ou un premier regard sur les données.
- 2D (Variations perpendiculaires au profil) 🏞️ : les propriétés varient avec et une direction horizontale , et sont constantes selon . Excellent compromis pour des structures longues et linéaires (vallées, failles). On résout sur un maillage 2D : bien plus coûteux que 1D, mais gérable.
- 3D (Géologie générale) 🧱 : solution complète, sans compromis. Les propriétés varient selon . Il faut résoudre sur une grille 3D volumineuse : coûteux en calcul, exige des machines puissantes et des algorithmes astucieux (solveurs matrix-free, préconditionneurs, etc.).
Point crucial : l’algorithme d’inversion que nous allons construire reste agnostique à ce choix. Seul change le « moteur physique » — le solveur direct 1D, 2D ou 3D que l’on y branche.
Paramétrisation du modèle à inverser
On inverse pour afin d’imposer la positivité (via l’exponentielle) et de rendre les pas d’optimisation multiplicatifs en . Les maillages numériques (couches 1D, cellules 2D/3D) sont des grilles de modèle ; les données du levé (impédances, champs) sont prédites aux emplacements récepteurs par interpolation et évaluation fonctionnelle. Les sensibilités sont prises par rapport à : le jacobien couple la physique à l’optimisation. (Astuce débutant : travailler en évite les valeurs négatives de conductivité et stabilise souvent la recherche.)
La fonction objectif à minimiser
L’inversion équilibre deux forces : ajuster les données fiables et rester géologiquement plausible. On code cela comme la somme d’un écart aux données pondéré et d’un régularisateur de modèle :
met à l’échelle chaque donnée selon son incertitude (et un plancher d’erreur optionnel). Si l’écart-type est connu, un choix classique est , de sorte qu’un « bon » ajustement correspond à un normalisé proche de 1.
favorise la structure attendue dans le sous-sol. En régularisation de Tikhonov lisse, empile des différences d’ordres 0/1/2, par ex. . On peut basculer en variation totale (TV) pour des contacts plus nets, et inclure un modèle de référence pour tirer la solution vers une géologie connue.
arbitre entre l’ajustement et la douceur. On commence souvent avec un élevé (stabilité d’abord), puis on le diminue (« refroidissement ») jusqu’à atteindre le niveau de bruit des données — c’est le principe de la discordance, visant .
Pour employer des solveurs à gradient, il nous faut la dérivée de par rapport au modèle :
Ici est la sensibilité (jacobien) et le résidu. En 1D, on peut souvent former explicitement ; en 2D/3D, on applique et de façon implicite via des résolutions directe/adjointes — essentiel pour la mémoire et la vitesse.
Options robustes (quand des valeurs aberrantes apparaissent)
L’écart quadratique est optimal pour un bruit gaussien. En présence de pics ou de décalages statiques, on remplace la norme au carré par une pénalité robuste , par ex. Huber ou Tukey. On conserve la sensibilité près de zéro tout en limitant l’influence des outliers, ce qui améliore la convergence et la stabilité du modèle.
Checklist pratique
• Définir des planchers d’erreur raisonnables dans
(p. ex., 5–10 % en amplitude, 1–2° en phase).
• Choisir en accord avec la géologie (lisse vs. « blocs »)
et fournir lorsqu’une information a priori
fiable est disponible.
• Programmer : commencer haut, puis réduire par un facteur
0.5–0.8 jusqu’à ce que atteigne le niveau de bruit.
• Travailler en pour garantir la positivité ; appliquer
des bornes par projection si nécessaire.
Ce qui arrive ensuite
Nous allons maintenant transformer la fonction objectif en algorithme. L’idée centrale est simple : linéariser la carte directe autour du modèle courant, résoudre une mise à jour de modèle qui fait baisser l’objectif, et recommencer. Cela conduit au système Gauss–Newton / Levenberg–Marquardt (GN/LM) :
La matrice de gauche mêle trois ingrédients : la courbure « donnée » (comment les variations du modèle affectent les données), la courbure de régularisation (comment elles affectent la rugosité), et l’amortissement qui contrôle la taille du pas. Quand on retrouve le pur Gauss–Newton ; quand est grand, le pas se comporte comme une descente de gradient prudente et bien conditionnée. Après avoir résolu pour , on accepte un pas échelonné via une recherche linéaire ou une région de confiance, puis on ajuste et de manière adaptative. (Astuce débutant : pensez à comme à un bouton « prudence ». Plus il est élevé, plus on avance doucement.)
Dans la Étape 2, nous dériverons soigneusement ce système et nous l’implémenterons en pratique :
- Terre 1D en couches. On exploite des modèles directs rapides basés sur la transformée de Hankel, avec des sensibilités analytiques ou des produits jacobien–vecteur peu coûteux. Cela donne des itérations rapides, idéales pour le contrôle qualité et pour bâtir l’intuition sur la profondeur d’investigation.
- 2D et 3D. On passe à la résolution d’EDP sur maillages. On ne forme
jamais explicitement : les gradients viennent des adjoints,
et le membre de gauche dans
Eq. \ref{eq:gn-lm}est appliqué en matrix-free via des méthodes de Krylov (CG/LSQR). De bons préconditionneurs et un planning de raisonnable font la différence entre quelques minutes et plusieurs jours.
À la fin de l’Étape 2, vous aurez une boucle GN/LM opérationnelle qui atteint une misfit cible (principe de la discordance), respecte les bornes en , et produit des modèles à la fois géologiquement plausibles et quantitativement justifiés.
Étape 2 — De la fonction objectif aux mises à jour (Gauss–Newton / Levenberg–Marquardt)
ous transformons l’objectif en algorithme. Linéarisons la carte directe autour du modèle courant : . Avec cette approximation quadratique, la minimisation de conduit aux équations normales :
Le membre de droite est le gradient avec le résidu . Les trois termes de gauche sont la courbure données, la courbure régularisation et l’amortissement . Un petit donne un pas de Gauss–Newton ; un grand se comporte comme un pas de gradient prudent.
Accepter le pas : recherche linéaire ou région de confiance
Résolvez pour (généralement avec CG/LSQR, en matrix-free). Choisissez ensuite une longueur de pas via une recherche linéaire d’Armijo avec backtracking, en appliquant les bornes dans si elles existent. Les variantes LM en région de confiance adaptent au moyen d’un rapport de gain :
Si est élevé (le modèle quadratique prédit bien la baisse), diminuez et autorisez des pas plus audacieux ; si est faible, augmentez et réessayez avec un pas plus court. Cela stabilise l’itération même quand la linéarisation est imparfaite.
Planifier (ajustement vs stabilité)
Démarrez avec un plus grand pour stabiliser les premières itérations, puis réduisez avec une fois que la misfit baisse. La cible est le niveau de bruit : pour un bon ajustement.
Boucle GN/LM 1D minimale (pseudocode)
import numpy as np

def phi(m, beta, Wd, Wm, F, d):
    f = F(m); r = f - d
    phid = 0.5 * np.linalg.norm(Wd @ r)**2
    phim = 0.5 * np.linalg.norm(Wm @ (m - mref))**2
    return phid + beta*phim, phid, phim, r

m = m0.copy(); beta = beta0; mu = mu0
for k in range(max_outer):
    f = F(m)                   # direct
    r = f - d
    J = J_1d(m)                # analytique ou JVP rapides
    g = J.T @ (Wd.T @ (Wd @ r)) + beta * (Wm.T @ (Wm @ (m - mref)))

    # Opérateur du membre gauche (appliqué via CG pour grands problèmes)
    A = J.T @ (Wd.T @ (Wd @ J)) + beta*(Wm.T @ Wm) + mu*np.eye(m.size)

    dm = solve(A, -g)          # Cholesky si petit; CG/LSQR si grand

    # Recherche linéaire Armijo avec bornes en log-sigma
    alpha = 1.0
    while alpha > 1e-4:
        m_trial = project_bounds(m + alpha*dm, lb, ub)
        phi_old, phid_old, _, _ = phi(m, beta, Wd, Wm, F, d)
        phi_new, phid_new, _, _ = phi(m_trial, beta, Wd, Wm, F, d)
        if phi_new <= phi_old - 1e-4*alpha*np.dot(g, dm):  # Armijo
            m = m_trial
            # Rapport de gain LM (optionnel) : mise à jour de mu
            denom = 0.5 * dm @ (A @ dm)
            rho = (phi_old - phi_new) / max(denom, 1e-12)
            mu = max(mu * (0.33 if rho > 0.75 else (3.0 if rho < 0.25 else 1.0)), mu_min)
            break
        alpha *= 0.5

    # Réduire beta quand la misfit normalisée approche 1
    if phid_new <= 0.5 * N_data:
        beta *= 0.7

    if np.linalg.norm(alpha*dm) < 1e-3 or k == max_outer-1:
breakCette boucle 1D est volontairement compacte : elle reflète exactement la logique que nous réutiliserons en 2D/3D, où des produits matrix-free remplacent les matrices explicites et où un CG préconditionné résout les équations normales. Ensuite, nous brancherons ce moteur sur un modèle direct 1D en couches pour retrouver un bassin conducteur simple — puis nous passerons à l’échelle en 2D et en 3D.
Étape 3 : Inversion 1D en pratique — retrouver un bassin conducteur
ettons à l’épreuve l’algorithme de l’Étape 2. Nous définissons un
« vrai » modèle à trois couches : une couche résistive
(100 m), puis un bassin conducteur
(10 m), au-dessus d’un socle résistif
(1000 m). Nous générons des données synthétiques avec
notre solveur direct 1D, ajoutons 5 % de bruit gaussien pour
simuler un levé réel, puis nous fournissons ces « observations »
à notre fonction inv1d_gnlm. L’inversion démarre d’un
demi-espace simple et non informé à 100 m.

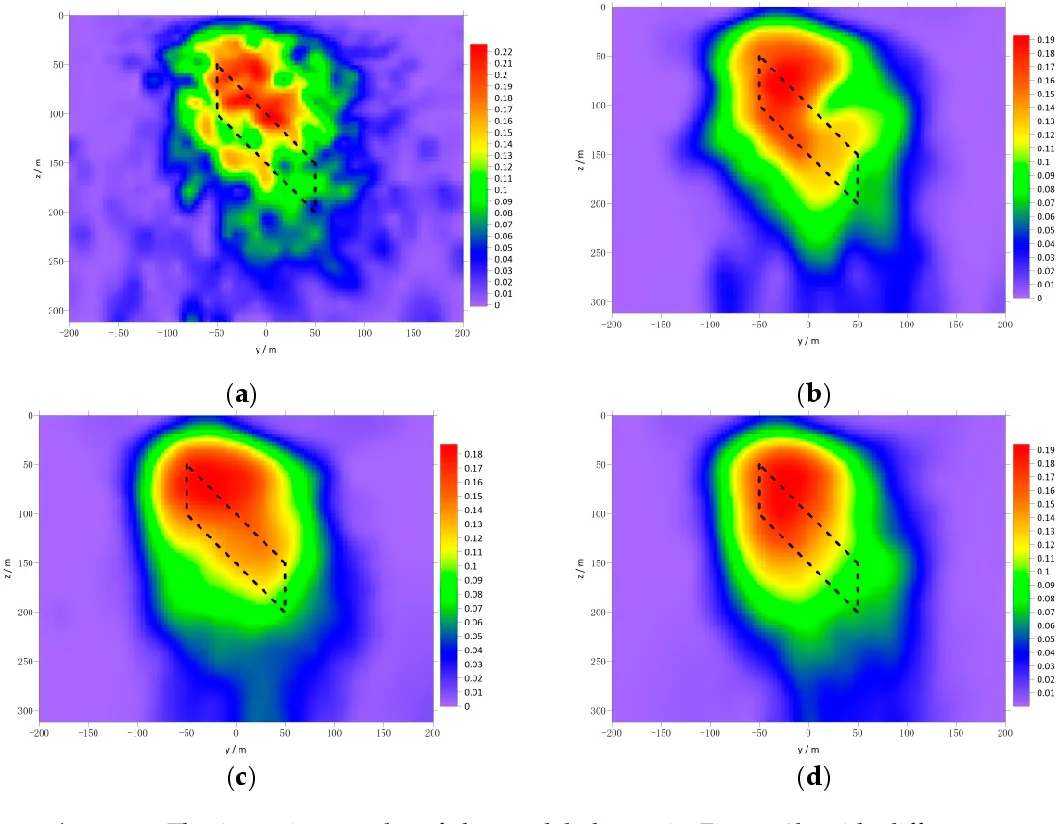
Le solveur converge en quelques itérations. Il commence avec un élevé, ce qui fait émerger d’abord les grandes structures (on l’observe sur les modèles des premières itérations). À mesure que la misfit aux données atteint sa cible (principe de la discordance), l’algorithme réduit automatiquement et permet d’ajuster les détails plus fins. Le modèle final résout clairement le bassin conducteur, montrant que notre boucle d’optimisation est stable et efficace. Astuce débutant : un trop faible trop tôt peut conduire à sur-ajuster le bruit ; commencez « stable », puis desserrez.
Étape 4 : Passer à l’échelle en 2D et 3D (approche matrix-free)
oici l’idée la plus puissante en inversion numérique : l’algorithme
d’optimisation écrit pour le 1D ne change pas quand on passe
en 2D ou 3D. Le pseudocode inv1d_gnlm.py, avec sa boucle
while, sa recherche linéaire d’Armijo et son planning de
, est exactement le même moteur que nous utilisons en
3D avec des millions de paramètres.
La seule chose qui change, c’est la manière de calculer quatre composants clés :
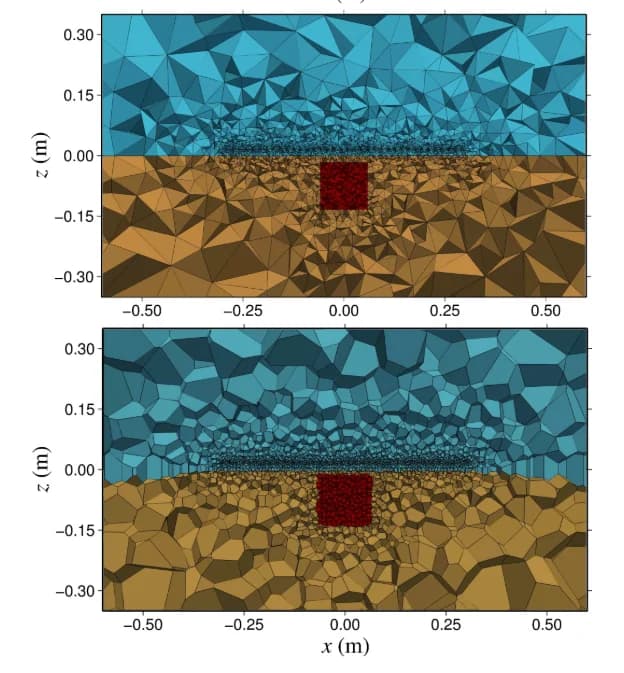
- (résolution directe) : au lieu d’une transformée de Hankel 1D rapide, on résout désormais une grande EDP sur un maillage 2D/3D (volumes finis, éléments finis, etc.).
- (résidu) : identique — on calcule la différence.
- (gradient) : on ne forme jamais le jacobien massif . On calcule le gradient complet (Éq.5) via un état adjoint. C’est une technique bien connue : coût d’environ une résolution supplémentaire de type « direct », quel que soit le nombre de paramètres.
- (système à résoudre) : on résout le système GN/LM (Éq. 6-7) avec un solveur de Krylov matrix-free (CG, LSQR). Ces méthodes n’ont pas besoin de la matrice elle-même ; elles requièrent seulement une fonction qui, étant donné un vecteur , renvoie le produit . Parfait pour nous, car ce produit s’obtient avec quelques (souvent deux) résolutions directes/adjointes par itération de CG.
Conclusion : un moteur d’optimisation unifié
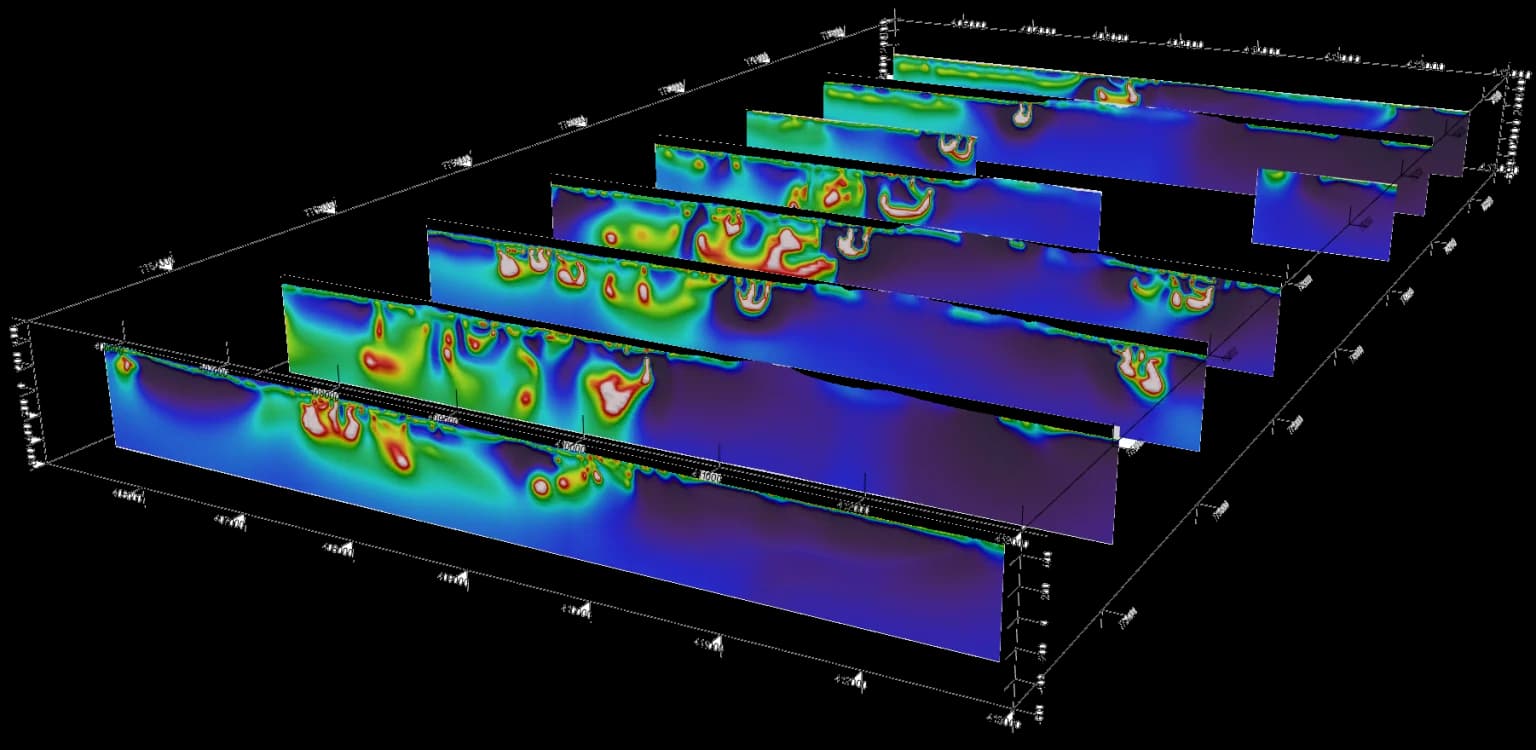
ous avons construit un modèle complet de l’inversion EM. Nous sommes partis de la physique directe (Éq.1) avons défini une fonction objectif pondérée et stable (Éq.2), puis avons dérivé l’algorithme de travail Gauss–Newton / Levenberg–Marquardt (Éq.6) pour la minimiser.
L’idée clé est que la logique d’optimisation est indépendante de
l’implémentation physique. En utilisant les adjoints pour le gradient
et des solveurs matrix-free pour l’étape de mise à jour, le
même algorithme s’étend d’un modèle 1D calculé en une
seconde à une inversion 3D en dix heures. Cette modularité — séparer
minimize(Objective) de
Objective.compute(gradient, residual) — est au cœur de
tous les cadres modernes d’inversion géophysique.